社内向けLLMチャットアプリ「Teruha」を構築しました
ミツエーリンクスでは業務におけるAI活用に取り組んでおり、今回、社内向けLLMチャットアプリ「Teruha」を構築しました。 本記事では、Teruhaを作った背景やシステム構成、構築を通じて得られた知見を紹介します。
Teruhaとは
Teruhaは、社内ネットワークから利用できるLLMアプリです。ブラウザ上のチャット画面から質問を入力すると、社内環境で稼働するLLMが回答を生成します。
「Teruha」は、一年を通して緑の葉を保つ「照葉樹」にちなんで名付けました。季節を問わず緑を保ち続ける照葉樹のように、Teruhaも社内向けLLMとして、いつでも安定して利用できる存在にしたいという思いを込めています。
基本的なチャットに加え、会話履歴の保存、Web検索の結果や登録したファイル・社内資料を参照した回答生成(RAG)などを利用できます。また、OpenAI互換APIも備えているため、ブラウザだけでなく社内のスクリプトや開発ツールから呼び出すことも可能です。
なぜ作ったのか
Teruhaを構築した主な目的は、生成AIを安全かつ継続的に全社展開することです。
一般的な生成AIサービスは手軽に利用できる一方、社員がそれぞれ異なるサービスやアカウントを利用すると、どこに何を入力してよいのか、どのような用途で使えるのかが分かりにくくなります。利用するUIとポリシーをTeruhaに集約することで、社員が迷わず生成AIを活用でき、管理側も統一したルールで運用できる状態を目指しました。
もう1つの目的はコストの削減です。外部のLLM APIは高性能ですが、利用量に応じて費用が増加します。全社員の利用を前提にすると、活用が進むほど年間の予算管理が難しくなる可能性があります。そこで、日常的な用途には社内のGPU上で動作するローカルLLMを使用し、外部モデルは必要な場合に限って利用可能にする方針としました。安全性や利便性だけでなく、コストを管理可能な状態にすることも重要な設計要件でした。
どのような構成にしたか
Teruhaは、既存のオープンソースソフトウェアを組み合わせて構築しています。
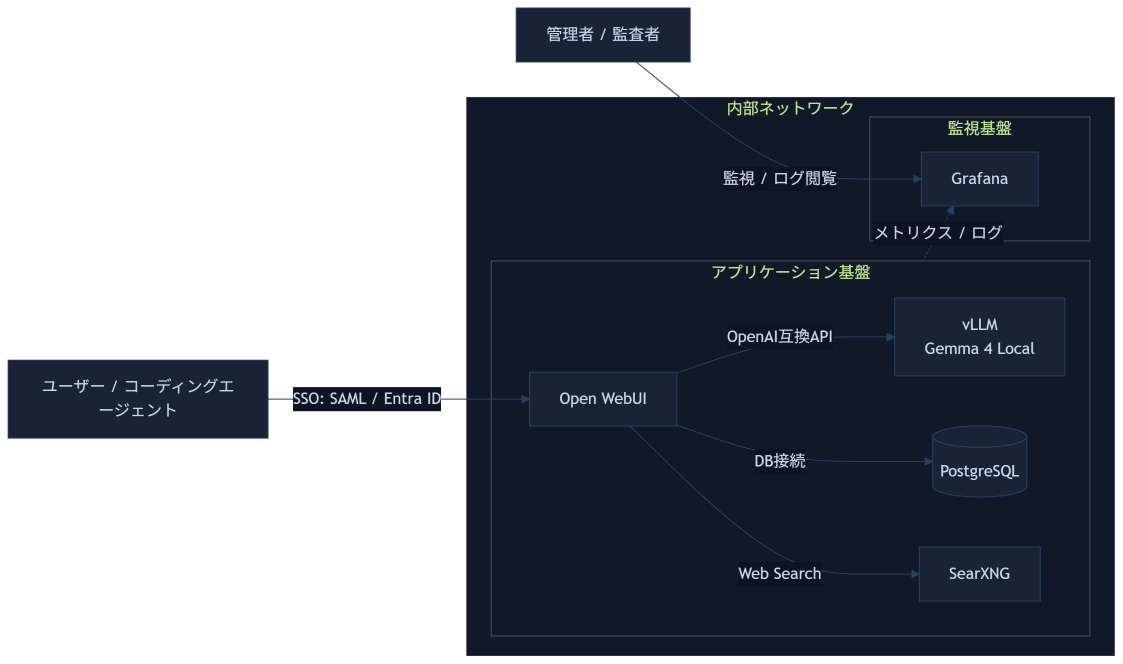
Open WebUI、vLLM、PostgreSQL、SearXNG、監視基盤で構成するTeruhaのシステム概要
チャット画面にはOpen WebUI、モデルの推論基盤にはvLLMを採用しました。vLLMはOpenAI互換APIを提供するため、UIや外部ツールとの連携を比較的シンプルに保てます。会話履歴やユーザー情報はPostgreSQLに保存し、Web検索にはSearXNGを使用しています。登録したファイルや社内資料を参照した回答生成(RAG)には、Open WebUIのナレッジ機能を利用しています。
また、PrometheusやGrafanaなどを使い、サーバーやコンテナ、GPUの状態を確認できる監視基盤も用意しています。
現在利用しているモデルは、量子化したGemma 4 26Bです。
構築で苦労したこと
特に苦労したのは、GPUメモリと回答品質・速度のバランスです。LLMは、モデルサイズやコンテキスト長が大きいほど、多くのGPUメモリを必要とします。
構築当初に採用したQwen 3では、期待していた回答品質を得られない場面がありました。その後、利用モデルをGemma 4へ変更したことで回答品質が大幅に向上し、半年ほどの開発期間だけでも、LLMが急速に進化していることを実感しました。
ただし、量子化していないGemma 4 26Bを動作させるには、用意したサーバーのGPUメモリが不足してしまったため、量子化モデルを選定し、モデルの品質をできるだけ維持しながら必要なメモリを削減しました。さらに、同時リクエスト数や応答時間を計測し、複数ユーザーが利用しても安定して応答できるよう推論設定を調整しました。
リリースとこれから
今回のリリースでは、社内アカウントで利用できるチャットUI、ローカルLLMによる文章生成、会話履歴の保存、Web検索やナレッジ参照といった、日常業務で生成AIを使い始めるための基盤を提供できました。
実際の利用者数や時間帯ごとの負荷、よく使われる機能、回答速度に対する評価などは、運用して初めて分かる部分もあります。今後は監視データや利用者からのフィードバックを確認し、推論設定、モデル、検索精度、UIを継続的に改善していきます。
Teruhaは、構築して終わりのシステムではありません。社員が安全に生成AIを試し、業務に役立つ使い方を見つけられる共通基盤として、利用状況を見ながら育てていく予定です。